8 min readAI
Claude Code ที่ Anthropic: PR เยอะขึ้น แต่ revert กลับน้อยลง
ช่วงนี้บน X มีการพูดถึงวิธีที่ Anthropic ใช้ Claude Code จน PR เพิ่มขึ้นแต่ต้อง revert น้อยลง ซึ่งฟังดูขัดกับสามัญสำนึก บันทึกจากเดฟ·PM ที่ดูแลทีม junior ว่ามันเป็นไปได้ยังไง และทีมเล็ก ๆ จะหยิบแนวคิดรีวิวแบบแบ่งชั้นตามความเสี่ยงมาใช้ได้แค่ไหน
 Sutthiphong NuanmaSoftware Developer
สัปดาห์นี้ไทม์ไลน์ X ของผมมีหัวข้อหนึ่งวนกลับมาให้เห็นบ่อยมากครับ
คนพูดถึงวิธีที่ทีมใน Anthropic ใช้ Claude Code ทำงานกันจริง ๆ และประเด็นที่คนหยิบมาเถียงกันมากที่สุดคือ จำนวน PR ที่ส่งเข้ามาเพิ่มขึ้นชัดเจน แต่จำนวนครั้งที่ต้อง revert กลับลดลง
ผมอ่านแล้วสะดุดทันที เพราะประสบการณ์ของผมเองบอกตรงกันข้าม
ทุกครั้งที่ทีมผมเร่งความเร็ว ส่งของถี่ขึ้น สิ่งที่ตามมาเกือบทุกรอบคือ hotfix กับ revert ที่เพิ่มขึ้นด้วย
ก่อนจะไปต่อ ขอออกตัวไว้ก่อนนะครับ ผมไม่ได้อยู่ใน Anthropic และไม่มีตัวเลขภายในของเขา สิ่งที่เขียนในโพสต์นี้คือสรุปจากสิ่งที่คนในวงการคุยกันบน X บวกกับมุมมองของผมในฐานะคนที่ดูแลทีม junior และต้องรับผิดชอบเวลาโค้ดพังบน production
สิ่งที่คนบน X คุยกัน
ถ้าสรุปแก่นของบทสนทนา มันมีอยู่ไม่กี่ข้อ
หนึ่ง AI เขียนโค้ดเป็นส่วนใหญ่ของงานประจำวัน คนไม่ได้นั่งพิมพ์ทุกบรรทัดเอง แต่สั่งงาน ตรวจ และตัดสินใจ
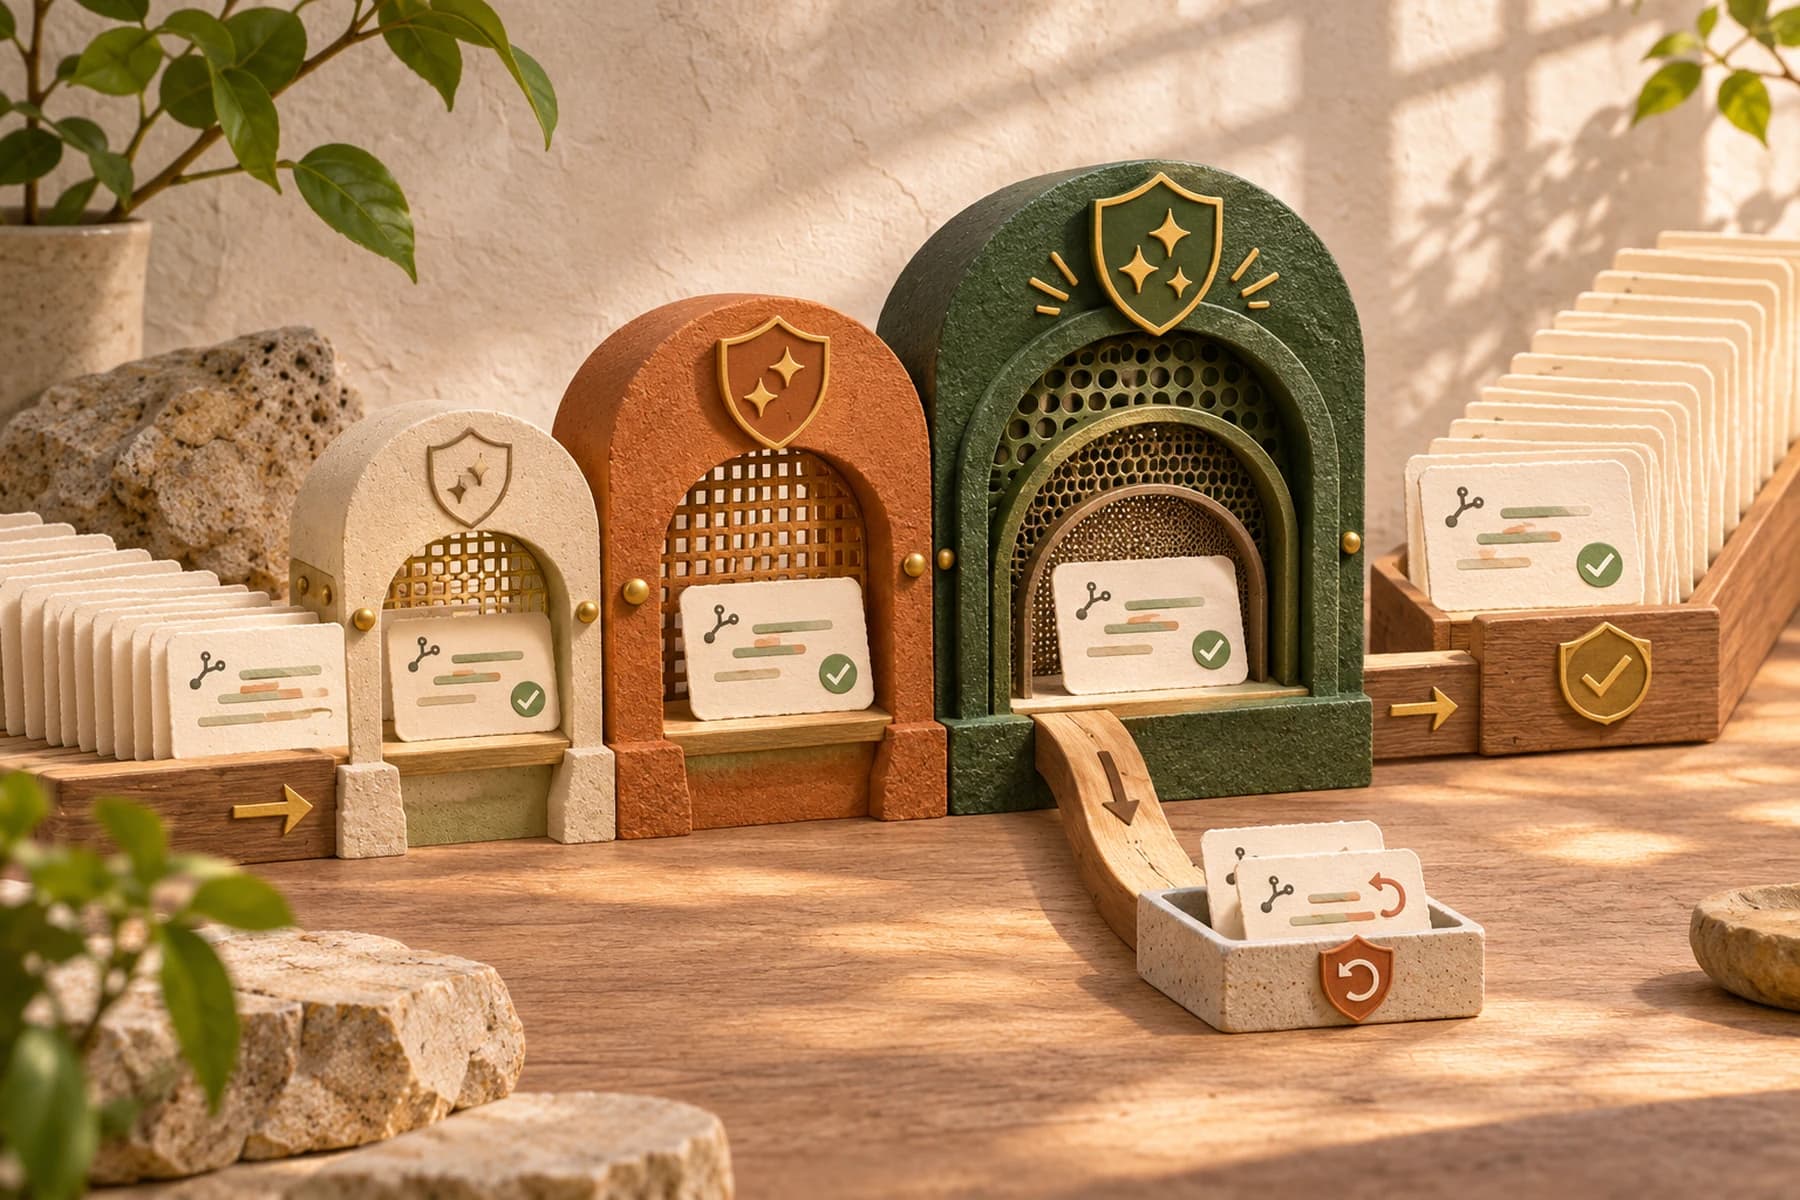
สอง การรีวิวไม่ได้ทำแบบเดียวกันทุก PR แต่แบ่งเป็นชั้นตามระดับความเสี่ยง งานความเสี่ยงต่ำผ่าน AI review และการตรวจอัตโนมัติเป็นหลัก งานความเสี่ยงสูงต้องมีคนรีวิวจริงจัง
สาม ผลลัพธ์คือ throughput สูงขึ้นโดยคุณภาพไม่ตก หรือบางคนบอกว่าดีขึ้นด้วยซ้ำ
ฝั่งที่สงสัยก็มีเยอะครับ บางคนบอกว่าเป็นการตลาด บางคนบอกว่า Anthropic มีวิศวกรระดับท็อป จะเอามาเทียบกับทีมทั่วไปไม่ได้ บางคนถามว่า revert น้อยลงเพราะโค้ดดีขึ้นจริง หรือเพราะ PR เล็กลงจนไม่มีอะไรให้ revert
ผมว่าข้อสงสัยพวกนี้มีน้ำหนักทั้งหมด และผมก็ไม่สามารถยืนยันตัวเลขใด ๆ ได้
แต่สิ่งที่ผมสนใจมากกว่าตัวเลข คือ กลไก ที่ทำให้เรื่องแบบนี้เป็นไปได้ เพราะกลไกพวกนั้นเอามาใช้กับทีมเราได้ ไม่ว่าตัวเลขของเขาจะเป็นเท่าไรก็ตาม
ทำไม PR เยอะขึ้นแต่ revert กลับลดลงได้
ตอนแรกผมคิดว่ามันฟังดูขัดกัน แต่พอนั่งไล่ทีละข้อ มันมีเหตุผลรองรับมากกว่าที่คิด
PR เล็กลง
เวลาคนเขียนโค้ดเอง เรามักจะรวมงานหลายอย่างไว้ใน PR เดียว เพราะการแยก branch แยก PR มันเหนื่อย พอ AI ทำส่วนที่น่าเบื่อแทน การแตก PR ออกเป็นชิ้นเล็ก ๆ ก็แทบไม่มีต้นทุน
PR ที่เล็กรีวิวง่ายกว่า เข้าใจง่ายกว่า และถ้าพังก็พังในวงแคบ จำนวน PR เลยเพิ่ม แต่ความเสี่ยงต่อ PR ลดลง
การรีวิวไม่ได้เป็นคอขวดเดียว
ในทีมทั่วไป PR ทุกตัวต้องรอคนเดียวกันรีวิว ซึ่งมักเป็น senior ที่งานล้นมืออยู่แล้ว ผลคือ senior รีวิวแบบผ่าน ๆ เพราะเหนื่อย PR ที่ควรโดนดูละเอียดเลยหลุดไปพร้อมกับ PR แก้ typo
พอแบ่งชั้น คนไม่ต้องเสียสมาธิกับงานความเสี่ยงต่ำอีกต่อไป เวลาและความตั้งใจของคนจะไปอยู่กับ PR ที่สำคัญจริง ๆ
AI ไม่เหนื่อย
AI reviewer อาจไม่ฉลาดเท่า senior ที่เก่งที่สุดในทีม แต่มันอ่านทุกบรรทัดของทุก PR ด้วยความตั้งใจเท่ากัน ตอนตีสองหรือตอนบ่ายวันศุกร์ก็ไม่ต่างกัน
ข้อผิดพลาดแบบ "ลืมเช็ก null" "ลืมจัดการ error" "เปลี่ยน signature แต่ไม่แก้ที่เรียกใช้" เป็นสิ่งที่คนพลาดบ่อยเวลาเหนื่อย และเป็นสิ่งที่ AI จับได้ค่อนข้างดี
test ถูกเขียนมากขึ้น
อันนี้เป็นสิ่งที่ผมเห็นในทีมตัวเองด้วย เมื่อการเขียน test ไม่ใช่ภาระที่ต้องฝืนทำ คนก็เขียนมากขึ้น และ test ที่มากขึ้นก็จับปัญหาได้ก่อนจะ merge
ทั้งหมดนี้รวมกันแล้ว PR ที่เพิ่มขึ้นกับ revert ที่ลดลงจึงไม่ได้ขัดกันเลยครับ มันเป็นผลจากการเปลี่ยนโครงสร้างของงาน ไม่ใช่แค่การทำงานเร็วขึ้น
ความเสี่ยงคือหัวใจ ไม่ใช่ AI
ถ้าให้ผมเลือกบทเรียนเดียวจากเรื่องนี้ ผมจะเลือกข้อนี้
สิ่งที่ทำให้ระบบนี้ใช้ได้ คือการแยกให้ออกว่างานไหนเสี่ยงแค่ไหน ไม่ใช่การมี AI ที่เก่ง
ทีมที่เอา AI มาใช้โดยไม่มีการแยกระดับความเสี่ยง จะเจอแค่สองแบบ แบบแรกคือให้คนรีวิวทุกอย่างเหมือนเดิม ผลคือ PR ท่วมจนคนรีวิวไม่ทัน แบบที่สองคือปล่อยให้ AI ผ่านทุกอย่าง ผลคือวันหนึ่งโค้ดที่แตะระบบจ่ายเงินหลุดขึ้น production โดยไม่มีใครดู
ผมเคยเห็นทีมที่เป็นแบบแรกมาแล้วครับ ทีมผมเองตอนเริ่มใช้ AI ก็เป็น junior ส่ง PR มาวันละหลายตัว ผมนั่งรีวิวจนไม่ได้ทำงานอื่น สุดท้ายผมเริ่มกด approve แบบไม่ได้อ่านละเอียด ซึ่งแย่กว่าตอนที่ PR น้อยกว่านี้อีก
ปัญหาไม่ใช่ว่า AI เขียนโค้ดแย่ ปัญหาคือกระบวนการรีวิวของเราไม่ได้ถูกออกแบบมารองรับปริมาณแบบนั้น
ทีมที่มี junior ต้องระวังอะไรเป็นพิเศษ
แนวคิดนี้ฟังดูดีมากสำหรับทีมที่ทุกคนเป็น senior แต่ทีมผมไม่ใช่แบบนั้น และผมเชื่อว่าทีมส่วนใหญ่ในไทยก็ไม่ใช่
มีสามเรื่องที่ผมกังวลเวลาเอามาใช้กับ junior
junior ประเมินความเสี่ยงของงานตัวเองไม่แม่น
สิ่งที่ junior มองว่า "แค่แก้นิดเดียว" บางทีไปแตะ query ที่วิ่งกับตารางใหญ่ที่สุดในระบบ ถ้าปล่อยให้คนเขียนเป็นคนติดป้ายความเสี่ยงเอง ระบบแบ่งชั้นจะพังตั้งแต่ต้น
junior เรียนรู้จากการโดนรีวิว
ถ้า PR ความเสี่ยงต่ำผ่าน AI review ไปหมด junior จะเสียโอกาสได้ฟีดแบ็กจากคน ซึ่งเป็นช่องทางหลักที่เขาจะเติบโต
junior เชื่อ AI ง่ายเกินไป
พอ AI reviewer บอกว่า "ดูดีแล้ว" junior มักจะไม่ถามต่อ ทั้งที่ AI ก็พลาดได้ โดยเฉพาะเรื่องที่ต้องรู้ context ของธุรกิจ
ทั้งสามข้อนี้ไม่ได้แปลว่าอย่าใช้ แต่แปลว่าต้องออกแบบระบบให้รองรับครับ
ขั้นตอนที่ผมเริ่มทำกับทีม
นี่คือสิ่งที่ผมทำจริงหรือกำลังทดลองอยู่ ไม่ได้สมบูรณ์แบบ แต่ใช้ได้กับทีมเล็ก
1. กำหนดระดับความเสี่ยงจากไฟล์ ไม่ใช่จากความรู้สึก
ผมเขียนรายการ path ที่ถือว่าเสี่ยงสูงไว้ในรีโป เช่น ส่วน auth ส่วนที่เกี่ยวกับเงิน migration ของ database และ config ของ infra
ถ้า PR แตะไฟล์ในรายการนี้ ระบบจะติดป้ายเสี่ยงสูงให้อัตโนมัติ และบังคับให้มีคนรีวิว ใช้ CODEOWNERS ร่วมกับ branch protection ก็ทำได้แล้ว ไม่ต้องมีเครื่องมือพิเศษ
แบบนี้ junior ไม่ต้องตัดสินเองว่างานตัวเองเสี่ยงแค่ไหน
2. AI review ทุก PR แต่ไม่ใช่ตัวตัดสินสุดท้ายของงานเสี่ยงสูง
ทุก PR ผ่าน AI review ก่อนเสมอ งานเสี่ยงต่ำ เช่น แก้ข้อความ ปรับ style เพิ่ม test ถ้า CI เขียว AI ไม่เจอปัญหา ก็ merge ได้
งานเสี่ยงสูง AI review ทำหน้าที่กรองรอบแรก ให้คนรีวิวได้โฟกัสกับเรื่องที่สำคัญ ไม่ต้องเสียเวลากับเรื่อง null check
3. จำกัดขนาด PR
ผมตั้งกติกาว่า PR ที่ใหญ่เกินกำหนดต้องแตก ยกเว้นงานที่ generate อัตโนมัติ ข้อนี้ช่วยมากกว่าที่คิด เพราะ PR เล็กทำให้ทั้ง AI และคนรีวิวได้แม่นขึ้น
4. สุ่มรีวิว PR ความเสี่ยงต่ำ
เพื่อแก้ปัญหาที่ junior ไม่ได้ฟีดแบ็ก ผมสุ่มหยิบ PR ความเสี่ยงต่ำที่ merge ไปแล้วมาดูทุกสัปดาห์ แล้วคอมเมนต์ย้อนหลัง
มันไม่ได้บล็อกงาน แต่ทำให้ junior รู้ว่ายังมีคนดูอยู่ และผมก็ได้เห็นว่า AI reviewer พลาดอะไรไปบ้าง
5. ให้ junior อธิบาย PR ด้วยคำพูดตัวเอง
ทุก PR ต้องมีคำอธิบายสั้น ๆ ว่าเปลี่ยนอะไร ทำไม และทดสอบยังไง ห้ามให้ AI เขียนแทนทั้งหมด
ข้อนี้ผมเข้มงวดที่สุด เพราะถ้า junior อธิบายไม่ได้ แปลว่าเขาไม่เข้าใจโค้ดที่ตัวเองส่ง ซึ่งอันตรายกว่าโค้ดที่มีบั๊กเสียอีก
6. วัด revert กับ hotfix ไม่ใช่แค่จำนวน PR
ถ้าวัดแค่ว่าทีมส่ง PR ได้กี่ตัว ทุกคนจะหาทางเพิ่มตัวเลขนั้น ผมเลยดูคู่กันเสมอว่ามีกี่ตัวที่ต้องย้อนกลับ หรือต้องแก้ตามหลังภายในไม่กี่วัน
ถ้า PR เพิ่มแต่ revert เพิ่มตาม แปลว่าเรากำลังเร็วขึ้นแบบผิดทาง
สิ่งที่ผมยังไม่แน่ใจ
เพื่อความแฟร์ ผมขอพูดถึงสิ่งที่ยังไม่มีคำตอบด้วยครับ
ผมไม่แน่ใจว่าระยะยาว junior ที่โตมากับ AI review จะมีสัญชาตญาณเรื่องคุณภาพโค้ดเท่ารุ่นที่โดนรีวิวแบบเข้มข้นจากคนหรือเปล่า
ผมไม่แน่ใจว่าการแบ่งชั้นแบบนี้จะยังใช้ได้ดีไหม เมื่อระบบโตจนเกือบทุกไฟล์กลายเป็น "เสี่ยงสูง"
และผมไม่แน่ใจว่าตัวเลขที่คนพูดถึงบน X จะเกิดขึ้นกับทีมที่ไม่ได้มีวัฒนธรรมการเขียน test และแยก PR ดีอยู่แล้วตั้งแต่ต้น
ผมเดาว่าส่วนหนึ่งที่ Anthropic ทำแบบนี้ได้ ไม่ใช่เพราะ AI อย่างเดียว แต่เพราะพื้นฐานทางวิศวกรรมของเขาแข็งแรงอยู่แล้ว AI แค่ขยายสิ่งที่มีอยู่ ทั้งด้านดีและด้านแย่
ท้ายที่สุด
สิ่งที่ผมได้จากบทสนทนานี้ไม่ใช่ "ใช้ Claude Code แล้วทีมจะเก่งขึ้น" ครับ
แต่คือการตระหนักว่า เมื่อการเขียนโค้ดถูกลง คอขวดย้ายไปอยู่ที่การรีวิวและการตัดสินใจ และถ้าเราไม่ปรับกระบวนการให้รองรับ ความเร็วที่ได้มาจะกลายเป็นหนี้ที่ต้องจ่ายคืนในรูปของ revert กับ hotfix
ให้ AI ดูแลงานที่ความเสี่ยงต่ำ ให้คนดูแลงานที่พังแล้วเจ็บ และอย่าลืมว่า junior ยังต้องการคนสอน
สำหรับผม นั่นคือหน้าที่ของ senior กับ PM ในยุคนี้ ไม่ใช่การรีวิวทุกบรรทัด แต่คือการออกแบบระบบที่ทำให้ทั้งทีมส่งงานได้เร็ว โดยไม่ต้องลุ้นทุกครั้งที่กด merge